知沿学术:把科学前沿带给你的 AI Agent
找到相关论文只是开始。要弄清一个领域如何发展至今、当下什么最重要、还有哪些问题悬而未决,则要花更多功夫。对 AI agent 来说更难:网页搜索给的是零散的链接和摘要,一篇论文 PDF 动辄几万个 token,又没有结构,agent 很难在有限的 token 预算内看清一个领域的全貌。
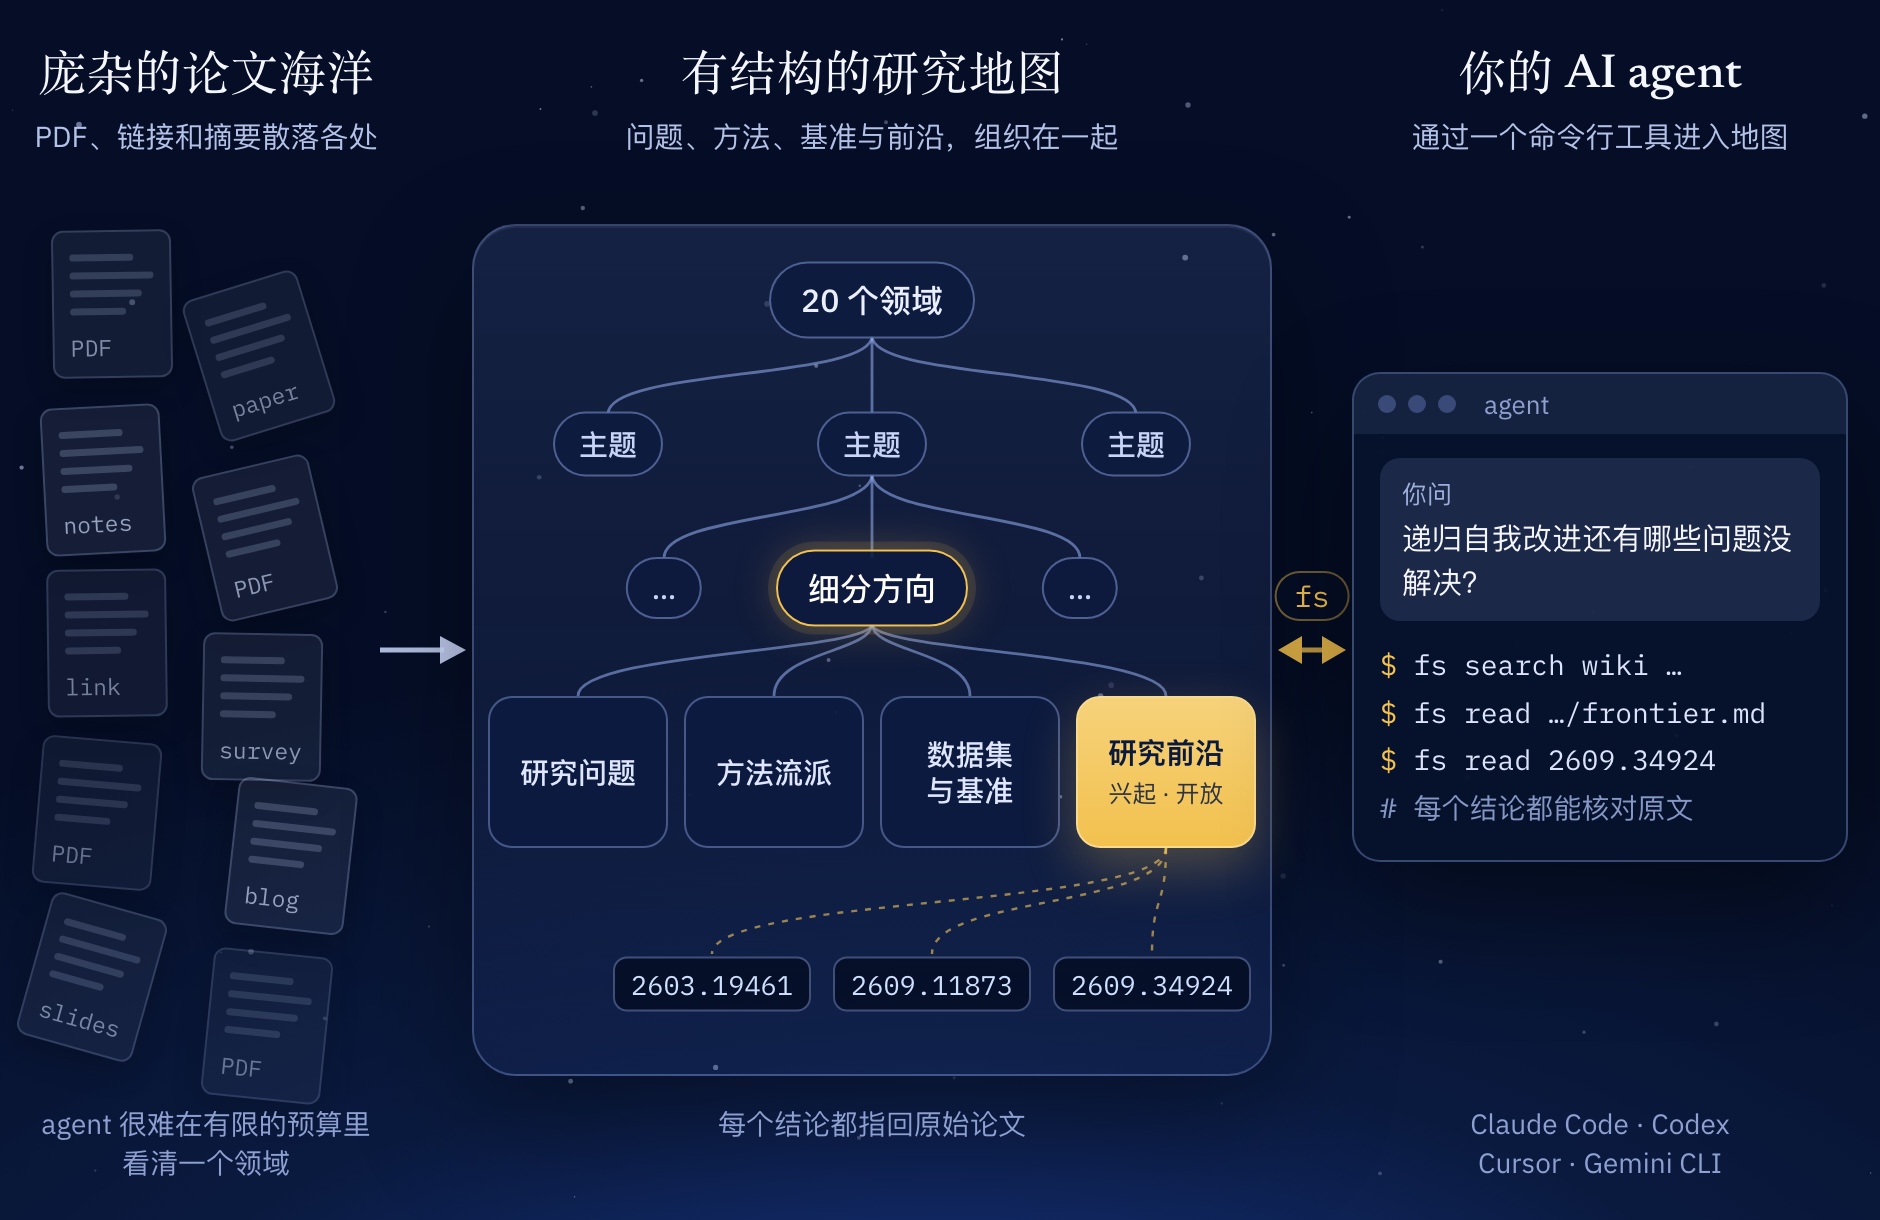
知沿学术(FrontierScholar)是一个为 AI agent 构建的科研知识库。我们把海量论文组织成一张有结构的研究地图:领域、主题、细分方向逐层展开;每个细分方向都有研究问题、方法流派、数据集与基准的专页,以及一页“研究前沿”,写明正在兴起的方法和尚未解决的问题。页面上的每个结论都能追溯到原始论文。agent 通过一个命令行工具 fs 来浏览、检索和阅读这张地图。
首个版本覆盖约 101 万篇计算机科学论文,免费使用,无需注册。
一张 agent 可以自主探索的研究地图
- 按研究方向组织:每个细分方向把它的关键问题、方法、基准和新兴方向放在一起,并相互关联。
- 帮 agent 看清进展:追踪一个方向的发展、比较不同方法、找出还没解决的问题;每一处判断都附上支撑它的论文,可以回到原文核对。
- 日期清晰:每篇论文都标有首次公开日期,可以按日期筛选,比如只看某个时间点之前的工作。
下面看两个例子。
例一:递归自我改进(recursive self-improvement)。 问 agent:“递归自我改进现在走到哪一步了?还有哪些问题没解决?”它会在地图上一步步找到答案:
- 找到方向:
fs search wiki --level subtopic "self-improvement",定位到“人工智能 → AGI 理论与机器意识 → 递归自我改进”。 - 看全貌:
fs read …/recursive-self-improvement,可以看到这个方向的 123 篇论文,以及研究问题、方法、资源和研究前沿等页面。 - 读前沿:
fs read …/recursive-self-improvement/frontier.md,页面列出正在兴起的方法和尚未解决的问题,以及每个问题最早由哪篇论文提出、有多少论文支撑。比如正在兴起的“模型与 harness 共同进化”,以及 2026 年 3 月才提出的开放问题:如何区分真正的自我改进和表面上的改进。 - 核对原文:
fs read 2609.34924,打开前沿页引用的这篇 2026 年 9 月的论文 [8],对照作者的摘要核实:“Rewriting scaffolding (tools, verifiers, decomposition) expands what an agent reaches without touching a weight”。
例二:AI 科学家(自动化科研)。 问:“端到端的 AI 科学家系统,主流做法有哪些?还有哪些问题没解决?”
agent 定位到“人工智能 → AI 驱动的科学发现 → 端到端 AI 科学家系统”(360 篇论文)。前沿页显示,正在兴起的方向包括可自我进化的科研 harness 和基于证据的结论准入;在开放问题中,“验证并不独立于生成”有 9 篇论文支撑,最新一篇发表于 2026-10-08。用 fs read 2610.11253 打开这篇论文 [9],摘要中写道:“explanation rubric rewards a distinction no legal experiment can make”。
四条命令,就能从一个问题追溯到原文证据。前沿页是我们对论文的综合整理,摘要则是作者原文;两者分开标注,agent 引用时能说清依据来自哪里。
在三类科研场景上的表现
我们在三类场景、四个公开评测集上测试了知沿学术:
- 论文检索:找到相关工作,并了解它们在整个研究领域中的位置(AutoResearchBench 的 Wide Research 子集 [1]、RealScholarQuery [2])。
- 报告生成:围绕一个主题写出有结构、有引用支撑的综述,覆盖进展、主流方法和挑战(ScholarQABench [3])。
- 研究构想:结合已有工作、新兴趋势和未解决的问题提出研究方案(IdeaScientist [4])。
我们对比了同一个 coding agent 的两种配置:接入知沿学术(Agent + 知沿学术),以及只使用网页搜索与抓取(Agent + 网页搜索与抓取)。此外还对比了 Google AI Studio(Gemini,开启 Google 搜索)[7]、alphaXiv [6] 和 Asta [5]。
| 方案 | AutoResearchBench | RealScholarQuery | ScholarQABench | IdeaScientist |
|---|---|---|---|---|
| Agent + 知沿学术 | 0.466 | 0.596 | 71.1 / 52.4 | 73.3 |
| Agent + 网页搜索与抓取 | 0.369 | 0.492 | 70.6 / 48.2 | 72.3 |
| Google AI Studio | 0.169 | 0.415 | 67.9 / 25.8 | 66.1 |
| alphaXiv | 0.240 | 0.413 | 65.8 / 41.7 | 72.5 |
| Asta | — | 0.215 | 67.0 / 44.6 * | 47.0 |
评测说明
- 指标:论文检索(AutoResearchBench 的 Wide Research 子集 400 题、RealScholarQuery 50 题)为召回率(0–1);ScholarQABench(100 题)为 rubric 分数 / 引用召回率(0–100,由 LLM 评判);IdeaScientist(240 题)为新颖性与质量的平均分(0–100)。
- Agent:两组都使用 pi 1.1.0 和 DeepSeek-V4.1-Flash(reasoning effort 为 high),只有工具不同:Agent + 知沿学术使用
fs命令行工具及其 skill,Agent + 网页搜索与抓取使用 DeepSeek 官方的 Search / Fetch API(以 pi 原生工具提供)。 - Google AI Studio:Gemini-3.8-Flash,thinking level 为 medium,开启 Google 搜索。
- alphaXiv:模型选择 DeepSeek-V4.1-Flash,开启网页搜索。
- Asta:RealScholarQuery 使用 Find Papers 与 Deep Search,IdeaScientist 使用 Deep Search。* ScholarQABench 上完成了 37/100 题。
论文检索的提升最明显:召回率比 Agent + 网页搜索与抓取高 21%–26%,比其他产品高 40% 以上。在报告生成和研究构想上,Agent + 知沿学术的 rubric 分数、引用召回率和总分也都高于其他方案。
从计算机科学开始,扩展到更多学科
首个版本覆盖计算机科学领域。接下来,我们会逐步纳入更多学科和更多类型的文献,长期目标是建立一张覆盖各学科、相互连通的科学文献地图。
在你的 agent 上试试
首个版本免费使用,无需注册,也不需要 API key。之后我们会开放注册,为有更高额度需求的用户提供账号。
pip install frontier-scholar                    # 安装命令行工具 fs(Python 3.8+,无依赖)
fs search paper "AI scientist" --topk 5          # 无需 key,直接可用

npx skills add FrontierScholar/FrontierScholar  # 为 coding agent 安装 skill
也可以直接下载 skill,解压到 agent 的 skills 目录:curl -fsSLO https://frontier-scholar.com/downloads/fs-cli.zip。
安装后,直接用自然语言提问即可,例如:“用 fs 查一下:递归自我改进还有哪些没解决的问题,哪些方法在兴起?”Claude Code、Codex、Cursor、Gemini CLI 等支持 skill 的 agent 都可以使用。
未注册时,每个 IP 每分钟最多 30 次请求、每天最多 300 次。命令和参数详见文档。欢迎告诉我们你希望覆盖哪些领域,以及你在研究中是怎么使用的。
参考文献
- AutoResearchBench: Benchmarking AI Agents on Complex Scientific Literature Discovery. arXiv:2604.25256, 2026.
- PaSa: An LLM Agent for Comprehensive Academic Paper Search(RealScholarQuery 出自本文). arXiv:2501.10120, 2025.
- OpenScholar: Synthesizing Scientific Literature with Retrieval-augmented LMs(ScholarQABench 出自本文). arXiv:2411.14199, 2024.
- IdeaScientist: Orchestrating Agents for Grounded Scientific Ideation. arXiv:2610.04074, 2026.
- Asta, Allen Institute for AI. asta.allen.ai;AstaBench: Rigorous Benchmarking of AI Agents with a Scientific Research Suite. arXiv:2510.21652, 2025.
- alphaXiv. alphaxiv.org
- Google AI Studio. aistudio.google.com
- Audit the Scaffold, Not the Checkpoint: A Stationarity Dichotomy for Recursive Self-Improvement in Agentic Coding. arXiv:2609.34924, 2026.
- LLM-IDEA: Identifiability-Driven Experimental Agent for Autonomous Discovery of Mechanistic World Models. arXiv:2610.11253, 2026.